同样是压缩,为什么有的图看不出差别,有的糊成一团
同一句话,用两种方式压缩,结果完全不一样。
把一张风景照和你家猫的照片都压到 100KB——风景照可能看不出区别,猫照片的毛就变成一片糊了。不是工具的问题,是图片内容本身的「可压性」不一样。
这篇不讲公式,讲清楚压缩算法到底在干什么,你就知道为什么有些图能压狠、有些不能。
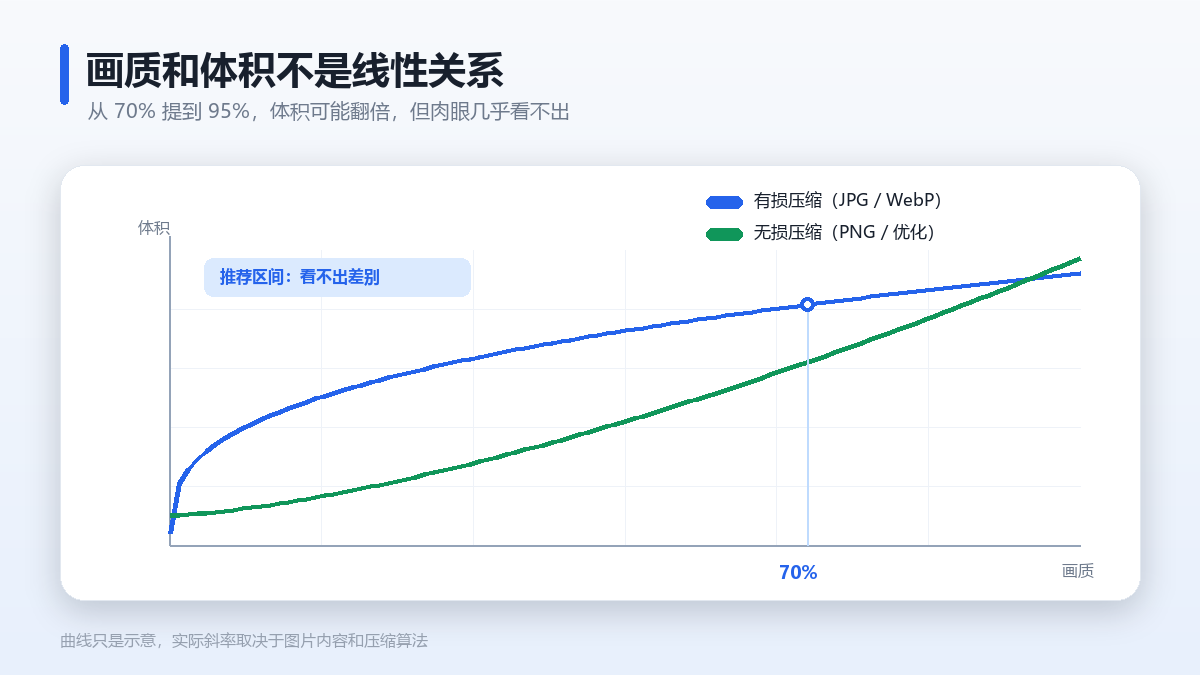
先分两类:无损和有损
无损压缩像给文件「打包」。它找到数据里的重复规律,用更省空间的写法表示,解压后一个字节都不差。ZIP、RAR 就是这个思路,图片里的 PNG 也是。
但无损压缩有个天花板:它能省多少,取决于数据本身有多「啰嗦」。一张截图里大块纯色,规律很强,能压到原来的十分之一;一张照片细节密集,规律少,只能省个两三成。
有损压缩则是另一回事——它会主动扔掉一部分数据,赌你发现不了。JPG、WebP、AVIF 都是有损格式。
JPG 在扔什么
JPG 的核心手段叫「离散余弦变换」,听着吓人,其实就是把图片切成一个个 8×8 的小方块,然后判断每一块里的「变化有多剧烈」。
变化平缓的地方(比如天空、墙面),它保留很少的信息;变化剧烈的地方(比如边缘、纹理),它保留得多。
为什么这么设计?因为人眼对「平缓区域的细节」不敏感,对「边缘」敏感。这跟听觉有点像:你更容易注意到有人说话,而不是背景里的空调声。
所以 JPG 压得狠的时候,最先崩掉的是:
细密的纹理(毛发、草地、布料的织物感)
渐变区域(天空出现一圈圈色带,叫「色阶断层」)
小字的边缘(振铃效应,文字周围一圈噪点)
反过来,大面积纯色的图片——比如 PPT 截图、Logo、简笔画——压狠一点也看不出问题,因为那些地方本来就没有「细节」可扔。
同样 100KB,为什么差别这么大
因为「100KB」只是一个总量限制,怎么分配这 100KB,算法是根据内容决定的。
一张细节多的图硬压到 100KB,算法只能把「不那么重要」的细节全扔了,结果就是你看到的一片糊。而细节少的图压到 100KB,空间还有富余,甚至能压到 50KB 还很好。
这也解释了一个常见困惑:为什么别人的图能压到 50KB 还很清楚,我的压到 200KB 就糊了——因为内容复杂度不同,不能横向比。
WebP 和 AVIF 先进在哪
JPG 的算法是 1992 年定下来的,那个年代的计算能力非常有限。WebP(2010)和 AVIF(2019)能用更复杂的计算换更好的压缩率。
简单说,它们的改进是:
不再固定切成 8×8 方块,而是根据画面内容灵活分块
能「预测」相邻区域,只记录差异
对人眼敏感度建模更精细
结果是:同样的画质,WebP 比 JPG 小 25–35%,AVIF 能再小 20–30%。
代价是编码更慢。JPG 压一张图几十毫秒,AVIF 可能要几秒。所以 AVIF 目前更适合「压一次、用很多次」的网站图片,不适合即时处理。
怎么判断一张图能压多狠
有几个经验判断,不用试错:
| 图片特征 | 可压程度 | 建议画质 |
|---|---|---|
| 大面积纯色(截图、PPT) | 很高 | 80 以上都没问题 |
| 风景、建筑(细节均匀) | 较高 | 70–80 |
| 人像(皮肤是渐变) | 中等 | 70–75 |
| 毛发、织物、密集纹理 | 较低 | 80 以上 |
| 小字、代码、表格截图 | 很低 | 85 以上,或别用有损 |
一个实用技巧:先按 70 压一次,仔细观察你最在意的那个区域(比如人脸、商品细节、文字)。如果看不出差别,就往 60 试;如果已经糊了,往 80 调。两三次就能找到这张图的最佳点。
几个常见误解
「压缩率越高越好」
不是。压缩率指的是「省了多少体积」,不是「压得多好」。一张图从 5MB 压到 100KB,压缩率 98%,但如果它原本该是 300KB 的质量,那就是压坏了。看体积够不够用,别看压缩率数字。
「无损压缩不会损失画质,所以肯定更好」
画质确实无损,但体积可能是 JPG 的五倍。网页上一张 1.2MB 的 PNG 换成 180KB 的 JPG,用户感知到的「清晰度」几乎一样,但加载速度快了好几倍。这时候「无损」反而是错的选项。
「压过的图放大就模糊,说明压缩差」
放大模糊是所有位图的通病,不是压缩造成的。原图放大到 400% 一样会糊。判断压缩效果要看原始尺寸下的细节,不是放大后。
最后
压缩不是「把文件变小」这么简单,是一场用人的视觉容忍度换空间的交易。算法在赌你看不出来,而你能做的,是控制它赌多大。
想知道你的图能压多狠,最直接的办法是压完用对比视图拖一下分隔线,自己看。这个判断比任何参数建议都准——毕竟最终是你在看这张图。